SECTIONS
EDITIONS
萬安百科算力领域的百科全书
萬安云(在建)
萬安百科算力领域的百科全书
萬安云(在建)
规格速查 SPEC CARD
NVIDIA A30
165W低功耗+24GB HBM2罕见组合,带FP64双精度5.2TF与NVLink 200GB/s,MIG可切4实例分租,是小机柜推理和HPC入门的高性价比选择
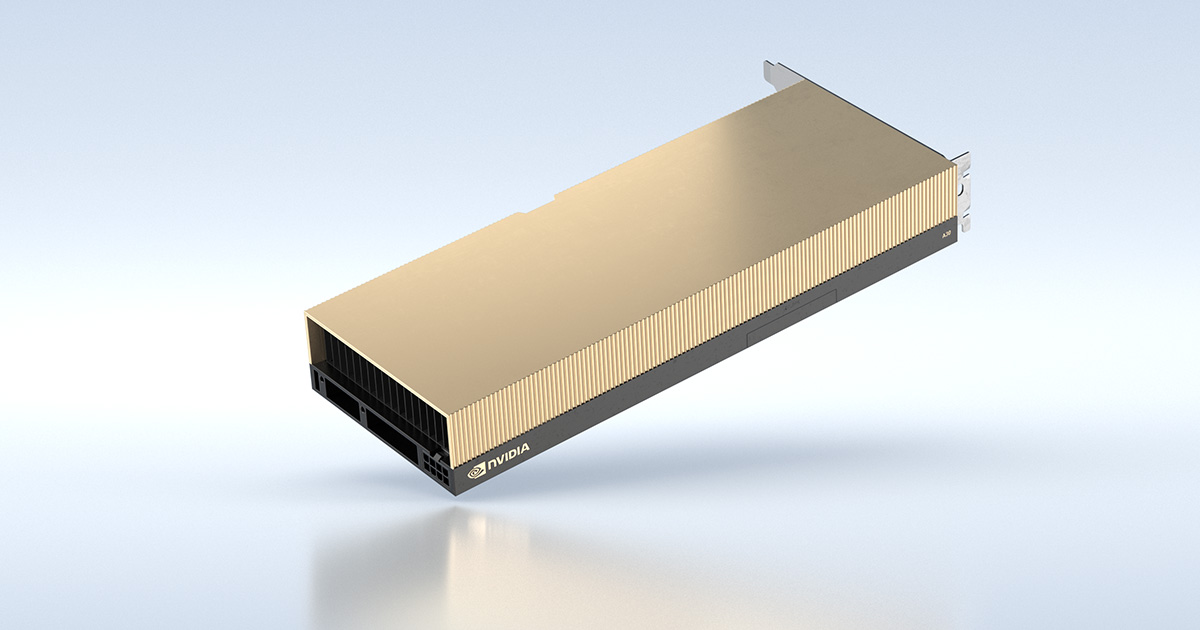
NVIDIA 厂商官方图
概述
NVIDIA A30是NVIDIA面向数据中心推出的Ampere架构加速卡,采用双槽全高全长(FHFL)形态,热设计功耗仅165W,属于低功耗档位的通用计算GPU。它配备24GB HBM2显存,带宽933GB/s,同时提供FP64双精度5.2 teraFLOPS的计算能力,并支持第三代NVLink互联(200GB/s)。凭借MIG多实例划分能力与Tensor Core加速,A30常被用于中等规模推理、入门级HPC计算以及多租户GPU资源池化场景,适合对功耗和空间敏感的机房部署。
核心规格
| 架构 | NVIDIA Ampere |
| 显存 | 24 GB HBM2 |
| 显存带宽 | 933 GB/s |
| FP32算力 | 10.3 teraFLOPS |
| FP64算力 | 5.2 teraFLOPS |
| TF32算力 | 82 teraFLOPS | 165 teraFLOPS |
| FP16算力 | 165 teraFLOPS | 330 teraFLOPS |
| INT8算力 | 330 TOPS | 661 TOPS |
| 功耗TDP | 165 W |
| 互联 | PCIe Gen4: 64GB/s / Third-gen NVLINK: 200GB/s |
| 形态 | Dual-slot, full-height, full-length (FHFL) |
| MIG | 4 GPU instances @ 6GB each |
规格已经官方资料核验(官方基准,更新于 2026-10-09)· 价格以货主实际报价为准
适用场景
- 中小规模AI推理服务:借助TF32/FP16/INT8等Tensor Core算力,可在低功耗条件下承载推理负载,MIG划分后还能为多路业务分别分配独立GPU实例
- 入门级HPC与科学计算:FP64双精度5.2 teraFLOPS及FP64 Tensor Core能力,可满足部分对双精度有需求的工程仿真与数值计算任务
- 多租户GPU资源池:通过MIG将单卡切分为4个6GB实例或2个12GB实例,适合云服务商或企业内部为多个用户隔离分配GPU资源
- 视频与图像处理:内置4路NVDEC视频解码器、1个JPEG解码器与光流加速器,可承担视频转码、图像分析等媒体处理负载
同族型号
| 型号 | 显存 | 功耗 |
|---|---|---|
| NVIDIA T4 对比 | 16GB GDDR6 with ECC (默认开启) | 70W (Total board power, 默认) |
| NVIDIA A100 对比 | 40GB HBM2 / 80GB HBM2e 双版本(80GB 版 2020-11-16 SC20 增发),带 ECC | SXM4 400W(40GB/80GB 同);PCIe 版 40GB 250W / 80GB 300W |
| NVIDIA H20 对比 | 96GB HBM3(Flopper/VipraTech/腾讯新闻三源一致) | 400W TDP(Flopper/VipraTech规格表/腾讯新闻'热设计功耗400W'三源;VipraTech正文另有350W矛盾口径已弃) |
| NVIDIA GB300 对比 | 288GB HBM3e(单GPU封装;超级芯片576GB;HGX板级2.1TB/机柜20TB并存) | TGP 最高 1400W |
| NVIDIA GeForce RTX 4090 对比 | 24GB GDDR6X | 450W TGP (平均游戏315W, 建议系统电源850W) |
| NVIDIA RTX PRO 6000 Blackwell 对比 | 96GB GDDR7 with ECC (单卡最大显存的专业工作站 GPU) | 600W Total board power (官方), 供电 1x PCIe CEM5 16-pin, 双贯穿式散热(Double-flow-through) |
视频讲解 VIDEO
采购与验货要点
- 确认机房供电与散热条件:A30热设计功耗为165W,整体功耗较低,但仍需按双槽全高全长(FHFL)尺寸确认服务器机箱兼容性,并保证风道满足散热需求
- 关注互联与拓扑规划:如需多卡协同,需确认服务器是否提供第三代NVLink桥接支持(200GB/s),PCIe侧为Gen4、双向带宽64GB/s,主机平台需匹配对应插槽规格
- 验货时核对显存与MIG配置:标配24GB HBM2显存、带宽933GB/s,需确认MIG功能可正常切分(4×6GB / 2×12GB / 单卡24GB),并通过NVIDIA官方工具验证设备真伪与固件状态
常见问题
NVIDIA A30和T4相比应该怎么选?
两者同为低功耗档位,但A30配备24GB HBM2显存、带宽933GB/s,并具备FP64双精度算力与NVLink互联,整体计算规格更高;T4功耗更低、形态更普及。若业务涉及较大显存需求、双精度计算或多实例池化,A30更合适;若仅做轻度推理且对预算敏感,可评估T4。
A30的MIG功能最多可以切几个实例?
A30通过Multi-Instance GPU技术最多可划分为4个GPU实例,每个实例分配6GB显存;也可以划分为2个12GB实例,或以单卡24GB整卡方式使用。实例之间资源隔离,适合多租户或多业务并行部署。
A30适合跑大模型训练吗?
A30的定位偏重推理与入门级HPC,24GB HBM2显存和FP16 Tensor Core 330 teraFLOPS(稀疏)的算力可支撑部分中小模型的训练或微调,但对于大规模模型训练,通常需要更高显存容量与NVLink多卡扩展能力的旗舰级产品,建议按实际模型规模评估。
资料更新 2026-10-09 · 升级深度词条走 编辑政策 流程